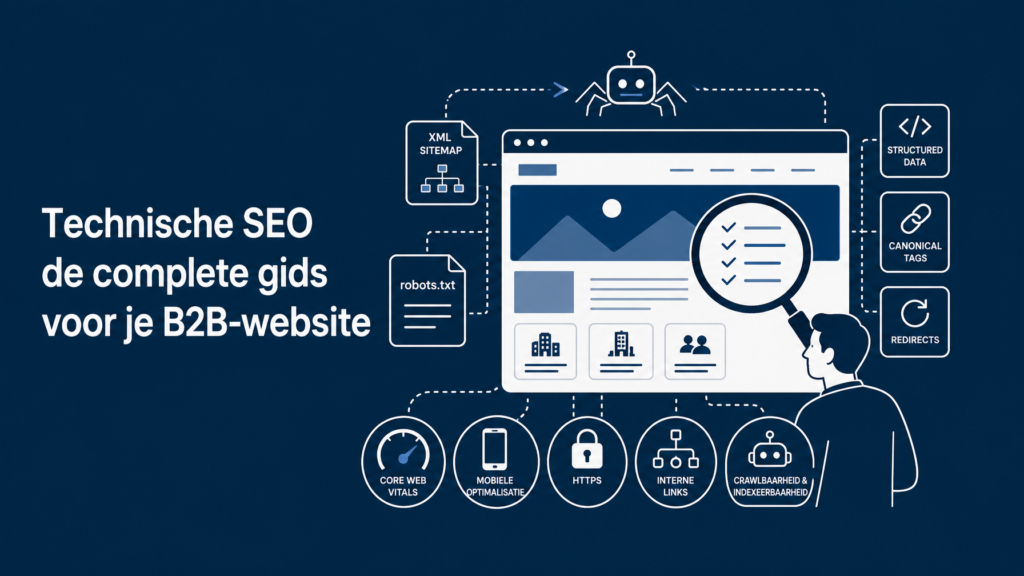
Technische SEO zorgt ervoor dat zoekmachines je website kunnen bereiken, crawlen, renderen en indexeren. Controleer eerst blokkades zoals robots.txt, noindex, canonicals, redirects en statuscodes. Controleer daarna Core Web Vitals, mobiele rendering, interne links en structured data. Een goede technische SEO-audit eindigt niet met een foutlijst, maar met een geprioriteerd actieplan per pagina of template.
Je publiceert content, werkt de dienstpagina’s bij en toch blijven de organische bezoekers achter. Of een auditrapport geeft honderden meldingen, maar je weet niet waar je moet beginnen. Dat is de situatie die veel marketingmanagers en directeur-eigenaren herkennen.
De vraag “wat moet ik technisch controleren?” betekent in de praktijk iets anders: welke problemen moet ik eerst oplossen en welke meldingen zijn ruis? Technische SEO gaat niet over het oplossen van elke toolmelding. Het gaat over het koppelen van elk probleem aan de juiste pagina of template, de commerciële betekenis ervan en de eerstvolgende uitvoerbare actie.
Deze gids legt begrippen uit, ordent de controlepunten en helpt je een technische audit te vertalen naar acties voor marketeer, developer en directie. Technische SEO is wel een randvoorwaarde, maar geen garantie op hogere rankings of meer leads. De uitkomst hangt ook af van content, relevantie, autoriteit, concurrentie en zoekintentie.
Wat is technische SEO?
Technische SEO is het geheel van maatregelen dat ervoor zorgt dat zoekmachines je website technisch correct kunnen verwerken. Dat verwerken bestaat uit vier afzonderlijke stappen: crawlen, renderen, indexeren en ranken. Elk van die stappen kan worden belemmerd door technische problemen, voordat content, relevantie of autoriteit überhaupt een rol spelen.
Googlebot bezoekt pagina’s via HTML-links, voert JavaScript uit om de volledige inhoud te renderen en slaat de verwerkte versie op in de Google-index. Pas daarna kan een pagina in aanmerking komen voor een ranking. Technische problemen op elk van die stappen kunnen de hele keten onderbreken.

De kernonderdelen van technische SEO zijn:
- Crawlbaarheid: kunnen zoekmachines de pagina’s op je website bereiken en doorzoeken?
- Indexeerbaarheid: mogen en kunnen die pagina’s worden opgenomen in de zoekindex?
- Website snelheid en Core Web Vitals: hoe snel en stabiel laadt de pagina voor echte bezoekers?
- Mobiele optimalisatie: is de mobiele versie inhoudelijk compleet en technisch correct?
- Websitestructuur en interne links: helpen de structuur en de links Googlebot om pagina’s te ontdekken?
- HTTPS en serverbetrouwbaarheid: is de verbinding veilig en geeft de server correcte HTTP-statuscodes terug?
- Structured data: begrijpt Google de inhoud en het type van de pagina?
Waarom technische SEO belangrijk is voor je website
Technische kwaliteit is een randvoorwaarde, geen rankinggarantie. Een website die Googlebot blokkeert via robots.txt, pagina’s op noindex zet, of een mobiele versie levert die de helft van de content mist, geeft zoekmachines onvoldoende basis om pagina’s correct te beoordelen.
Voor B2B-websites heeft dat directe gevolgen. Dienstpagina’s, aanvraagformulieren en productcategoriepagina’s die niet indexeerbaar zijn, genereren geen organische bezoekers. Trage laadtijden verhogen het bouncepercentage op landingspagina’s. Gebroken interne links laten Googlebot stoppen voor pagina’s die commercieel relevant zijn.
Technische SEO ondersteunt SEO voor B2B-bedrijven als geheel, maar werkt alleen als de bevindingen worden omgezet in concrete acties. Een schone technische basis maakt content, interne links en autoriteit effectiever. Zonder die basis kunnen die factoren minder goed tot hun recht komen.
Kan een technisch probleem je organische zichtbaarheid blokkeren?
Ja, en dat gebeurt vaker dan verwacht. Een noindex-instructie op een belangrijke dienstpagina zorgt dat die pagina volledig uit de zoekresultaten wordt gehouden, ongeacht de kwaliteit van de content. Een robots.txt-blokkade voorkomt dat Googlebot de pagina überhaupt bezoekt. Een verkeerde canonical stuurt de indexatiewaarde naar een andere URL dan bedoeld.
Hoofdcontent die alleen zichtbaar is na JavaScript-rendering kan door Googlebot worden gemist als de pagina niet correct wordt gerenderd. In al die gevallen is de technische fout de directe oorzaak van verminderde of ontbrekende organische zichtbaarheid, niet de content zelf.
Technische SEO-checklist: de belangrijkste controlepunten
Hieronder staat een prioriteitstabel met de meest impactvolle technische controlepunten. De labels geven de orde van aanpak aan: los eerst blokkades op, daarna hoge impact, daarna verbeteringen en onderhoud.
| Controlepunt | Controlevraag | Mogelijke impact | Bron of tool | Prioriteitslabel |
|---|---|---|---|---|
| Indexeerbaarheid kernpagina’s | Staan cruciale pagina’s op noindex? | Volledig uit zoekresultaten | URL Inspection, Search Console | Blokkade |
| Robots.txt | Zijn belangrijke mappen of bestanden geblokkeerd? | Crawling onmogelijk | robots.txt-viewer, GSC | Blokkade |
| XML-sitemap | Bevat de sitemap canonieke, indexeerbare URL’s? | Ontdekking vertraagd | GSC, sitemap-validator | Blokkade/hoge impact |
| Canonical tags | Verwijst canonical naar de bedoelde URL? | Verkeerde pagina geïndexeerd | URL Inspection, crawltool | Hoge impact |
| HTTP-statuscodes | Zijn er 404’s, 500’s of soft 404’s op indexeerbare pagina’s? | Crawlbudget verspild | GSC, crawltool | Hoge impact |
| Redirectketens | Zijn er ketens van meer dan één redirect? | Crawlefficiëntie verlaagd | Crawltool | Hoge impact |
| Mobiele rendering | Is de mobiele versie inhoudelijk compleet? | Mobile-first indexering benadeeld | GSC, mobiele weergavetest | Hoge impact |
| Core Web Vitals | Halen kernpagina’s LCP, INP en CLS in velddata? | Gebruikerservaring en signaal | PageSpeed Insights, GSC | Hoge impact |
| Interne links | Zijn er orphan pages of gebroken interne links? | Ontdekking geblokkeerd | Crawltool, GSC | Verbetering |
| Structured data | Is de markup geldig en overeenkomstig zichtbare content? | Rich-result-eligibility | Rich Results Test | Verbetering |
| HTTPS | Worden alle pagina’s via HTTPS geleverd? | Vertrouwen en signaal | Browser, GSC | Onderhoud |
De 10 controles die je eerst uitvoert
Begin bij indexeerbaarheid: controleer via URL Inspection of de kernpagina’s van je website zijn geïndexeerd en of er geen noindex-instructie op staat. Controleer daarna je robots.txt op onbedoelde blokkades van mappen als /diensten/, /producten/ of /contact/.
Controleer je XML-sitemap op het aanwezig zijn van canonieke, indexeerbare URL’s en voeg hem toe aan Google Search Console. Bekijk canonical tags op pagina’s met dubbele URL’s en redirects van HTTP naar HTTPS. Controleer statuscodes op de meest bezochte pagina’s en identificeer redirectketens.
Controleer de mobiele weergave van je belangrijkste templates. Meet Core Web Vitals in velddata via PageSpeed Insights. Identificeer orphan pages via een crawl. Valideer structured data via de Rich Results Test.
Crawlbaarheid en indexatie verbeteren
Crawlbaarheid en indexeerbaarheid zijn twee afzonderlijke concepten. Crawlbaarheid betekent dat Googlebot de pagina kan bereiken en de inhoud kan opvragen. Indexeerbaarheid betekent dat Google de pagina mag en kan opnemen in de zoekindex.
Een pagina kan crawlbaar zijn maar niet indexeerbaar, bijvoorbeeld door een noindex-instructie. Een pagina kan ook onbereikbaar zijn voor Googlebot via robots.txt, terwijl er geen noindex-instructie op staat. Die twee mechanismen werken onafhankelijk van elkaar, en het verwarren ervan leidt tot verkeerde prioriteiten.
Gebruik het Pagina-indexeringsrapport in Google Search Console om uitgesloten URL’s te bekijken en te categoriseren. URL Inspection geeft per pagina inzicht in de gecrawlde versie, de indexatiestatus en eventuele structured data. Voeg een XML-sitemap toe als hint voor ontdekking, maar behandel een sitemap nooit als garantie dat alle vermelde pagina’s worden geïndexeerd.
Wat is het verschil tussen robots.txt en noindex?
Robots.txt stuurt het crawlinggedrag van Googlebot. Als een URL is geblokkeerd in robots.txt, bezoekt Googlebot die pagina niet. Dat klinkt als een eenvoudige manier om indexatie te voorkomen, maar dat is het niet: Google Search Central geeft aan dat een geblokkeerde pagina toch in de index kan verschijnen als andere websites ernaar linken, omdat Google de URL dan nog steeds kan kennen zonder de inhoud te kennen.
Noindex is een instructie op pagina- of header-niveau die Google vertelt de pagina niet op te nemen in de zoekindex. Dat werkt alleen als Googlebot de pagina kan crawlen en de instructie kan lezen. Blokkeer een pagina via robots.txt én zet er noindex op: dan leest Googlebot de noindex-instructie nooit.
Gebruik robots.txt om crawlbudget te sturen op grote websites. Gebruik noindex voor pagina’s die je echt uit de index wilt houden.
Canonicals, dubbele URL’s en redirects controleren
Een canonical tag is een voorkeurssignaal, geen absolute opdracht. Google gebruikt het als sterke hint, maar kan in bepaalde gevallen een andere URL als canonical kiezen als die URL sterkere signalen heeft, zoals meer interne links of een hogere positie in de sitemap. Zorg dat canonical tags consistent zijn met de sitemap, de interne links en de redirectinrichting.
Redirectketens lopen via meerdere tussenliggende URL’s. Elke extra stap in een keten kost crawlbudget en kan signaalverdunning veroorzaken. Gebruik 301-redirects voor permanente wijzigingen. Een 308-redirect behoud de HTTP-methode en wordt door Google als vergelijkbaar met een 301 behandeld. Soft 404’s zijn pagina’s die een 200-statuscode teruggeven maar inhoudelijk leeg of foutief zijn. Google herkent ze als suboptimaal en kan ze uitsluiten van de index.
Website snelheid en Core Web Vitals optimaliseren
Core Web Vitals zijn de drie officiële prestatiewaarden die Google gebruikt om gebruikerservaring te meten. Ze zijn gebaseerd op echte gebruiksdata uit het Chrome User Experience Report (CrUX) en worden gemeten bij het 75e percentiel: 75% van de bezoeken moet een goede score halen. Dat is velddata, geen labdata.
PageSpeed Insights en Lighthouse leveren labdata: een gesimuleerde meting op een gecontroleerd apparaat. Velddata geeft het beeld over echte bezoekers en weegt zwaarder voor de gebruikerservaring. Een hoge PageSpeed-labscore sluit een slechte velddata-score niet uit. Controleer beide, maar baseer je beslissingen op de velddata in Google Search Console.

Welke Core Web Vitals moet je controleren?
De drie actuele Core Web Vitals zijn, op basis van de officiële web.dev-documentatie:
| Metric | Wat het meet | Goede drempelwaarde | Diagnosetools |
|---|---|---|---|
| Largest Contentful Paint (LCP) | Laadprestatie van de hoofdinhoud | Tot en met 2,5 seconden | PageSpeed Insights, GSC |
| Interaction to Next Paint (INP) | Reactiesnelheid op invoer | Tot en met 200 milliseconden | PageSpeed Insights, GSC |
| Cumulative Layout Shift (CLS) | Visuele stabiliteit tijdens laden | Tot en met 0,1 | PageSpeed Insights, GSC |

Voor B2B-websites zijn grote hero-afbeeldingen een veelvoorkomende oorzaak van een slechte LCP-score. Zware JavaScript-initialisatie op aanvraagformulieren verhoogt INP. Lettertypes, afbeeldingen of advertenties die laat laden veroorzaken CLS. INP verving in 2024 de voormalige metric FID, die alleen de eerste interactie mat.
Mobiele SEO en gebruiksvriendelijkheid
Google gebruikt de mobiele versie van je website als basis voor crawling en indexering. Dat heet mobile-first indexing. Als je mobiele template minder content bevat dan de desktopversie, ziet Google minder content dan je misschien verwacht.
Controleer de volgende punten voor mobiele SEO:
- Is de mobiele versie inhoudelijk gelijk aan de desktopversie?
- Zijn title tags, meta descriptions en structured data aanwezig op de mobiele template?
- Zijn alle afbeeldingen, scripts en stylesheets crawlbaar door Googlebot Smartphone?
- Is de tekst leesbaar zonder horizontaal scrollen?
- Zijn knoppen en links groot genoeg voor mobiele interactie?
Responsive design is de aanbevolen aanpak: één URL, één HTML-bestand, aanpasbare weergave op basis van het apparaat. Dat vermindert de kans op inhoudsverschillen tussen mobiel en desktop en vereenvoudigt crawling.
Websitestructuur, URL’s en interne links
Een logische websitestructuur helpt Googlebot pagina’s te ontdekken en de relatie tussen pagina’s te begrijpen. Denk aan de structuur van een B2B-website als een hiërarchie: homepage, dienstpagina’s, subcategoriepagina’s, blogartikelen en contact- of aanvraagpagina’s.
Interne links zijn de verbindingen die die hiërarchie leesbaar maken voor zoekmachines. Gebruik HTML-links met beschrijvende ankerteksten. JavaScript-gebaseerde navigatie kan door Googlebot worden gemist als de links niet als crawlbare HTML-links worden gerenderd. Controleer via een crawltool of alle commercieel relevante pagina’s via interne links bereikbaar zijn.
Orphan pages zijn pagina’s die via geen enkele interne link bereikbaar zijn. Ze kunnen worden geïndexeerd als ze in de sitemap staan, maar Googlebot vindt ze niet via reguliere crawling. Voeg interne links toe vanuit relevante pagina’s om ze bereikbaar te maken. Houd de klikdiepte beheersbaar voor belangrijke commerciële pagina’s: hoe dieper een pagina in de structuur zit, hoe minder frequent Googlebot er naartoe navigeert.
Gebruik beschrijvende URL’s zonder overbodige parameters, sessie-ID’s of getallencombinaties zonder betekenis. Een URL als /diensten/seo-audit/ is informatiever dan /pagina?id=47.
HTTPS, serverbetrouwbaarheid en JavaScript
HTTPS is de standaard voor webverkeer. Pagina’s die nog via HTTP worden geleverd, tonen een beveiligingswaarschuwing in browsers en geven een zwakker vertrouwenssignaal. Controleer of alle pagina’s via HTTPS worden geleverd en of de redirect van HTTP naar HTTPS correct verloopt zonder redirect-loops of ketens.
JavaScript-afhankelijkheden kunnen technische SEO compliceren. Als de hoofdcontent van een pagina alleen zichtbaar is na JavaScript-rendering, moet Googlebot die rendering correct kunnen uitvoeren. Google Search Central legt uit dat crawling, rendering en indexering drie afzonderlijke stappen zijn die niet altijd tegelijk plaatsvinden. Hoofdcontent die pas na rendering beschikbaar is, kan later worden geïndexeerd dan statisch beschikbare content.
Soft 404’s zijn een specifiek risico. Een pagina die een HTTP 200-statuscode teruggeeft maar inhoudelijk leeg is of een foutmelding toont, misleidt Googlebot. Geef echte 404-pagina’s de juiste 404- of 410-statuscode terug en controleer via het Pagina-indexeringsrapport in Search Console of soft 404’s worden gesignaleerd.
Structured data en rich results
Structured data is markup die Google helpt de betekenis en het type van de inhoud op een pagina te begrijpen. Het wordt aanbevolen in JSON-LD-formaat en gebaseerd op Schema.org-specificaties. Structured data kan een pagina eligible maken voor bepaalde rich results in de zoekresultaten, maar garandeert die weergave niet.
De officiële documentatie van Google Search Central is duidelijk: markup moet overeenkomen met de zichtbare inhoud op de pagina. Voeg geen structured data toe voor content die de bezoeker niet ziet. Dat geldt voor reviews, prijzen, FAQ’s en andere gegevens.

Voor een B2B-blog of kennisbank zijn Article of BlogPosting relevante typen. BreadcrumbList ondersteunt de navigatieweergave in zoekresultaten als de breadcrumb zichtbaar op de pagina staat. Valideer markup met de Rich Results Test en controleer na publicatie de structured-data-rapporten in Google Search Console.
Zo voer je een technische SEO-audit uit
Een technische SEO-audit is gerichter dan een algemene SEO-audit uitvoeren: de focus ligt op technische bereikbaarheid, crawlbaarheid, indexeerbaarheid, performance en rendering. Gebruik dit stappenplan als basis:
- Doel en scope bepalen. Welke templates en URL’s zijn commercieel het meest relevant? Begin bij dienstpagina’s, aanvraagformulieren en productcategoriepagina’s.
- Search Console controleren. Open het Pagina-indexeringsrapport en bekijk alle uitgesloten URL’s. Controleer de oorzaak per categorie: noindex, soft 404, redirect, canonical.
- URL Inspection gebruiken. Test de vijf tot tien meest commercieel relevante URL’s afzonderlijk op indexatiestatus, canonical, mobiele rendering en structured data.
- Crawl uitvoeren. Gebruik een crawltool om alle interne links, statuscodes, canonicals, redirects, title tags en meta descriptions te verzamelen.
- Performance meten. Controleer Core Web Vitals in velddata via PageSpeed Insights en in Search Console onder het rapport Core Web Vitals.
- Mobiele rendering controleren. Bekijk de mobiele weergave van kernpagina’s op inhoudsvolledigheid en correcte metadata.
- Structured data valideren. Test relevant gemarkeerde pagina’s via de Rich Results Test.
- Prioriteren. Orden bevindingen op impact, schaal en urgentie. Gebruik de matrix blokkade, hoge impact, verbetering en onderhoud.
- Implementeren en hertesten. Voer fixes door en hertest via URL Inspection of het desbetreffende Search Console-rapport.
Welke tools heb je nodig voor een technische SEO-audit?
| Tool | Waarvoor | Beantwoordt niet |
|---|---|---|
| Google Search Console | Indexatiestatus, Core Web Vitals, sitemapstatus, rich results | Technische oorzaak van problemen |
| URL Inspection | Gecrawlde versie, canonical, rendering per URL | Sitebreed overzicht |
| PageSpeed Insights | Velddata en labdata per URL | Alle URLs tegelijk |
| Rich Results Test | Structured data validatie | Of rich result daadwerkelijk verschijnt |
| Browsercontrole | Mobiele weergave, HTTPS, consolemeldingen | Geautomatiseerde schaal |
| Crawltool (optioneel) | Sitebreed overzicht van statuscodes, links, canonicals | Velddata of gebruikersgedrag |
Hoe prioriteer je technische SEO-problemen?
Gebruik vier categorieën als redactioneel prioriteringsadvies:

- Blokkade: probleem verhindert crawling of indexering van een commercieel relevante pagina. Los dit als eerste op.
- Hoge impact: probleem schaadt gebruikerservaring of indexatiekwaliteit op schaal. Pak dit op in de eerstvolgende sprintcyclus.
- Verbetering: probleem verlaagt efficiëntie of mist een kans, maar blokkeert niet direct. Plan voor het komende kwartaal.
- Onderhoud: periodieke controle nodig, geen directe actie vereist.
Beoordeel elk probleem op vijf criteria: impact op relevante templates, commerciële waarde van de betrokken pagina’s, urgentie (actief dalende indexatie vraagt sneller ingrijpen), implementatie-inspanning en wie de actie kan uitvoeren.
Veelgemaakte fouten bij technische SEO
De meest voorkomende fouten zijn niet altijd de meest gevonden meldingen in een tool. Ze zijn de fouten die de meeste schade aanrichten op de pagina’s die er het meest toe doen.
Noindex op commerciële pagina’s. Soms worden dienstpagina’s of aanvraagformulieren onbedoeld op noindex gezet tijdens een websitewijziging. Controleer dit via URL Inspection na elke grotere update.
Robots.txt als indexatiebeveiliging. Robots.txt blokkeert crawling, maar garandeert geen uitsluiting uit de index. Gebruik noindex voor pagina’s die je echt wilt verbergen.
Sitemap met niet-canonieke URL’s. Als de sitemap URL’s bevat die verwijzen naar pagina’s met een canonical naar een andere URL, geeft dat tegenstrijdige signalen. Vul de sitemap alleen met canonieke, indexeerbare URL’s.
Redirectketens. Meerdere opeenvolgende redirects zijn inefficiënt. Breng de definitieve bestemmings-URL direct in kaart en configureer de redirect in één stap.
Orphan pages. Pagina’s zonder interne links worden niet via reguliere crawling gevonden. Ze missen signaaloverdracht via interne links en komen minder frequent aan bod bij indexupdates.
Mobiele templateverschillen. Als de mobiele versie andere content, kortere teksten of ontbrekende structured data heeft ten opzichte van desktop, heeft dat gevolgen voor mobile-first indexering.
Foutieve structured data. Markup die niet overeenkomt met zichtbare content of die gebruik maakt van Schema.org-typen die niet passend zijn voor de pagina, kan leiden tot afkeur door Google.
Toolscore-fixatie. Het najagen van een perfecte PageSpeed-labscore leidt soms tot wijzigingen die weinig effect hebben op velddata. Prioriteer velddata en de gebruikerservaring boven een abstracte totaalscore.
Technische SEO prioriteren en onderhouden
Er is geen universele auditfrequentie die voor elke website geldt. De juiste aanpak hangt af van de situatie.
Voor een stabiele kleine B2B-website met weinig templatewijzigingen is een kwartaalcontrole van de belangrijkste Search Console-rapporten en een jaarlijkse uitgebreidere crawl een redelijk startpunt. Bij een grote templatewijziging, een CMS-migratie of het toevoegen van een nieuwe taalversie is een volledige technische controle direct voor en na de wijziging noodzakelijk.
Koppel controles aan concrete triggers: een plotselinge daling in indexatie, een nieuw rapport in Search Console, een websitemigratie, of een wijziging in Core Web Vitals-drempelwaarden. Leg bevindingen vast per URL of template, met vermelding van de bron, de datum en de verantwoordelijke voor de actie.
Voor content, backlinkanalyse en autoriteitsopbouw sluit je aan op een bredere SEO-audit uitvoeren. Technische SEO is een specifiek deelgebied en een afzonderlijk te onderhouden onderdeel.
Wanneer is technische SEO uitbesteden logisch?
Niet elke situatie vraagt om externe hulp. Maar in een aantal gevallen is specialistische ondersteuning zinvol:
- De website draait op een JavaScript-framework waarbij rendering en indexatie lastiger te controleren zijn.
- Er staat een websitemigratie gepland waarbij URL-structuren, CMS of hosting veranderen.
- De interne capaciteit ontbreekt om bevindingen uit een audit op te volgen met concrete implementatie.
- Search Console signaleert een onverklaarbare daling in indexatie die intern niet wordt herleid.
Wanneer is uitbesteden minder logisch? Als de website geen relevante zoekintentie bedient, als technische bevindingen intern niet worden opgevolgd door development, of als er geen commerciële pagina’s zijn die baat hebben bij betere organische zichtbaarheid. Een bureau is dan niet de juiste eerste stap.
Volgende stap: maak van je technische SEO-checklist een actieplan
Een technische SEO-audit krijgt pas waarde als bevindingen worden omgezet in een uitvoerbaar actieplan. Gebruik deze drie stappen als vertrekpunt:
- Controleer indexatieblokkades op de commercieel meest relevante pagina’s via URL Inspection.
- Orden bevindingen op impact en schaal. Wijs per bevinding een eigenaar aan: marketeer, developer of directie.
- Plan een hertest na implementatie via de juiste Search Console-rapporten of URL Inspection.
Koppel technische verbeteringen aan organische zichtbaarheid en relevante B2B-conversies, maar claim geen causaal resultaat zonder meetdata. Technische SEO is een onderdeel van een breder geheel.
Vragen of samenwerken? Neem gerust contact op.
Veelgestelde vragen over technische SEO
Wat is technische SEO?
Technische SEO omvat alle maatregelen die zorgen dat zoekmachines je website kunnen crawlen, renderen, indexeren en correct verwerken, inclusief snelheid, mobiel en structured data.
Waarom is technische SEO belangrijk?
Technische SEO is de randvoorwaarde voor organische vindbaarheid. Zonder technisch correcte basis kunnen content en autoriteit minder goed tot hun recht komen in zoekresultaten.
Wat is het verschil tussen crawlen en indexeren?
Crawlen is het bezoeken en opvragen van een webpagina door Googlebot. Indexeren is het opnemen van de verwerkte pagina in de Google-index, zodat die in aanmerking komt voor een ranking.
Wat is het verschil tussen robots.txt en noindex?
Robots.txt stuurt crawlgedrag en blokkeert paginabezoeken. Noindex is een instructie op paginaniveau die Google vertelt de pagina niet in de index op te nemen.
Hoe controleer ik of mijn pagina is geïndexeerd?
Gebruik URL Inspection in Google Search Console voor individuele pagina’s. Het Pagina-indexeringsrapport geeft een sitebreed overzicht van geïndexeerde en uitgesloten URL’s.
Welke Core Web Vitals moet ik controleren?
Controleer LCP (max. 2,5 seconden), INP (max. 200 milliseconden) en CLS (max. 0,1) in velddata via PageSpeed Insights en Google Search Console, gemeten bij het 75e percentiel.
Is structured data verplicht voor SEO?
Nee, structured data is niet verplicht. Passende markup kan Google helpen de inhoud te begrijpen en een pagina eligible maken voor rich results, maar garandeert die weergave niet.
Kan ik zelf een technische SEO-audit uitvoeren?
Voor een overzichtelijke website met beperkte JavaScript-afhankelijkheden kan dat goed via Search Console, URL Inspection en PageSpeed Insights. Complexe rendering, migraties of grote templates vragen specialistische kennis.
Hoe vaak moet ik technische SEO controleren?
Er is geen universele frequentie. Controleer bij websitewijzigingen, migraties, indexatiedalingen en kwartaalmatig de meest relevante Search Console-rapporten.
Wanneer is technische SEO uitbesteden logisch?
Als interne capaciteit ontbreekt voor implementatie, bij JavaScript-frameworks, bij migraties, of wanneer Search Console problemen signaleert die intern niet worden opgelost.